你好,我是上海KEMBO 总经理 CTO 佐々木。
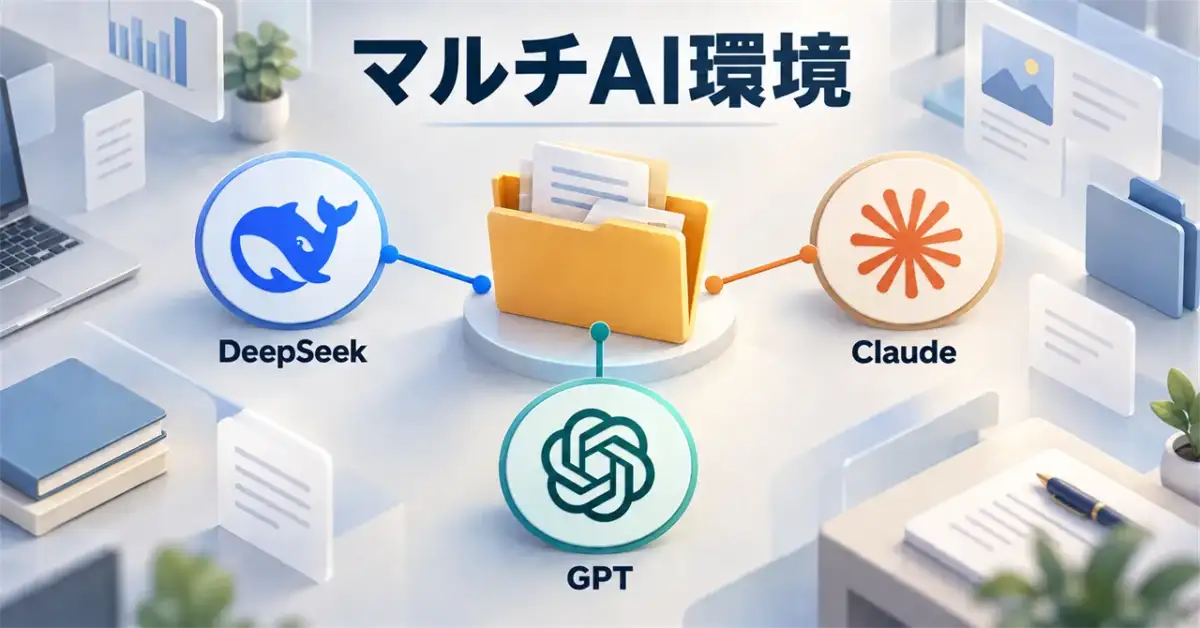
上一篇文章,我和常驻中国做生意的朋友们聊了聊AI环境方面需要有的准备。这次想具体写一写,我是如何搭建这套”可以自由切换引擎的多AI环境”的。
为什么要搭建多AI环境
原因主要有三个:
- 作为准备,即使某个特定AI无法使用,也不影响业务继续进行;
- 优秀的AI和便宜的AI层出不穷,不想被某一家绑死,保留灵活性;
- 作为在中国做生意的立场,也想把中国的AI用起来。
最主要的理由:搭建一套能纳入中国AI的环境
三个理由中,分量最重的是最后一个。我的业务据点在上海。与其只依赖西方AI,不如提前搭建一套环境,让中国的AI(如DeepSeek等)也能以同样的方式使用。这就是这次搭建环境的出发点。
作为附带的效果,我也可以按每个AI的擅长领域来分配工作。比如Claude虽然不能直接生成图片,但很擅长理解图片、构思整体设计。于是设计部分交给Claude来做,再原样把”照这个思路画出来”的指令交给GPT,这样就形成了分工。让GPT从头开始设计我觉得有点浪费,所以这种分工方式对我来说很实用。
即便加入了付费方案,有时候单次会话的Token也会用尽。把工作分散到多个AI上,也能让消耗更均衡、更有效率。
另外,DeepSeek虽然在8月涨价了,但即便如此依然比其他AI便宜,所以在处理耗时较长的任务时,我依然会用DeepSeek。
设计要点①:设计MD文件的读取方式
搭建这套环境的基础是Markdown(MD)文件。首先要把”启动时就会读取的文件”和”只有在做特定工作时才会读取的文件”清晰地区分设计好。
麻烦的是,不同AI最初读取的文件不一样。Claude会读取CLAUDE.md,但很多其他AI读取的是AGENTS.md。所以我把基本规则都汇总在AGENTS.md里,CLAUDE.md里只放一个指向它的链接。在最上层写好”在这个环境里应该这样运作””请阅读这个文件并遵循其中的规则”这样的指示。把需要读取的文件汇总成一条链接,是设计上的一个要点(不同AI也会有例外)。
设计要点②:按负责领域分别留存记录
我按主题或项目把工作分成不同的”负责人(担当)”,并在各自的MD文件里记录目前的状况、已经决定的事项,以及接下来要做的事。这和软件开发中的版本管理有点类似,目的是让每个负责领域的来龙去脉都可以被追溯。
这和Git(管理源代码变更历史的机制)是两码事。我平时使用的工作文件并没有用Git管理。用Git管理的,是把这套环境整理成可以分享给他人使用的”分发用骨架(Skeleton)”这个工具本身。这两者不要混淆。
备份方面,只要把MD文件和工作文件放在云端(比如OneDrive)就足够了。在多台电脑之间使用时,这个方法也很方便。
设计要点③:区分使用子智能体
不同的AI,有的可以调用子智能体(分担工作的下级AI),有的不能。不能调用的情况下,会出现不同的模式:或者由多个AI互相协作后再返回主体,或者由主体调用轻量模型来执行具体作业。
就我自己而言,如果需要进行大量的轻量调研,会把调研工作交给DeepSeek的V4 Flash或Claude的Sonnet这类轻量模型。至于信息收集的具体指示,则由更高阶、更强大的模型来下达。对收集到的信息进行整理和分配(策划整理),我也经常使用价格相对低廉的模型。具体在哪种场景使用哪个模型,我会根据成本和精度的平衡来决定。
在成本方面,像DeepSeek这样的中国系AI,比Claude和GPT要便宜得多。具体价格会有变动,感兴趣的话可以到官方页面确认(DeepSeek官方价格页面、Anthropic官方文档)。能把耗时较长的处理交给便宜的AI来完成,在实际工作中确实帮了大忙。
作为准备的安全措施
把信息交给多个AI处理,难免有人会担心安全问题。这里也可以搭建这样一套机制:在中间加入一个本地运行的轻量AI(LLM),在信息发送到外部之前,先把公司名称、机密信息等进行编码或匿名化处理,再发送出去。
第一步:直接问AI
读到这里,或许有人会觉得”这对我来说有点难”。但我推荐的第一步其实很简单:直接问AI。
只要告诉AI”听说有人搭建了这样的环境,我也想照着做”,对话就能从这里展开。只要脑子里有”我想做到这样的事”这个大概的想法就足够了。先动手试试看,我认为是最快的捷径。
结语
多AI环境不需要一次性做到完美。先搭建一个负责人,准备好一个MD文件,从这里一点点扩展就足够了。对于在中国做生意的人来说,拥有一套可以把中国AI也纳入其中、灵活切换的环境,本身就是一种准备。